 latent
Quería saber si Jev podía encontrar mejores vacantes que los embeddings convencionales. Ya tenía una interfaz de búsqueda funcionando, publicaciones reales y un modelo que emitía juicios de relevancia. Eso alcanza para una demo decente. No me dice si conviene pagar por la llamada al modelo.
Así que incorporé tres modelos locales de embeddings a la misma interfaz, guardé sus vectores en PostgreSQL con pgvector y ejecuté la comparación. Después agregué un LLM como juez independiente porque no iba a revisar a mano más de mil pares de petición y vacante.
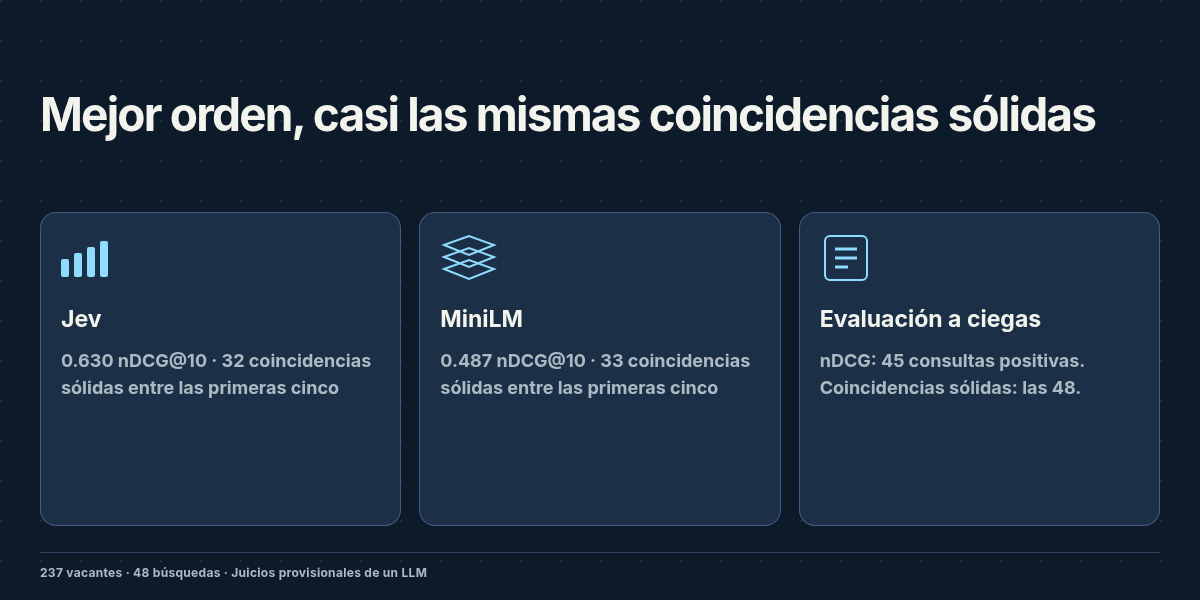
Jev ganó en la métrica de ordenamiento graduado. Cuando conté solamente las coincidencias sólidas entre los primeros cinco resultados, MiniLM tuvo 33 y Jev tuvo 32.
Ese resultado me sirve más que una victoria limpia. Me dice qué parte de la lista mejoró y qué afirmación todavía no puedo hacer.
Qué comparé
La evaluación con datos reales congeló 237 vacantes elegibles y ejecutó 48 búsquedas predefinidas con cuatro métodos. Cada búsqueda se repitió dos veces para medir tiempos. Las mediciones de calidad usan solamente la primera repetición, para que un segundo intento no sustituya un resultado inconveniente.
Los modelos de embeddings fueron sentence-transformers/all-MiniLM-L6-v2, BAAI/bge-small-en-v1.5 y snowflake/snowflake-arctic-embed-s. Los tres corrieron localmente en CPU. Sus búsquedas usaron similitud coseno exacta en pgvector. No había un índice de vecinos aproximados que introdujera otra fuente de error de recuperación.
Las descripciones se codificaron en fragmentos de 600 caracteres con 100 caracteres de solapamiento, combinados mediante un promedio normalizado. Esa es una forma de representar los documentos, con sus propias limitaciones. No he demostrado que sea la mejor configuración para ninguno de estos modelos.
El sistema con Jev recuperó primero hasta 30 candidatos mediante coincidencias léxicas y alias, y después evaluó los primeros 1,000 caracteres del texto de búsqueda de cada candidato. Los métodos de embeddings buscaron en todo el corpus elegible usando sus representaciones documentales.
Esa diferencia importa. Estoy comparando los sistemas que construí. La recuperación de candidatos puede impedir que Jev vea una buena vacante, y el texto recortado puede ocultar un requisito que sí aparece en la representación de embeddings. No puedo atribuir cada diferencia en los números finales a la inteligencia del modelo.
TypeSafe describe Jev como un modelo para emitir juicios tipados que el software puede consumir directamente. Su primitiva Choice, por ejemplo, devuelve una opción seleccionada, probabilidades y confianza. En esta aplicación usé Jev para evaluar la relevancia de los candidatos. Ese fue el comportamiento que puse a prueba.
El juez no sabía qué método produjo cada resultado
Para cada consulta reuní los primeros diez resultados de los cuatro métodos y agregué dos vacantes seleccionadas al azar cuando estaban disponibles. Una vacante devuelta por varios métodos se evaluó una sola vez para esa consulta. Así obtuve 1,399 pares únicos de petición y vacante.
GPT-6.1 Sol evaluó la petición contra la publicación completa y sus metadatos explícitos. No vio el método de recuperación, la posición ni su puntuación. La rúbrica permaneció fija y el modelo devolvió una calificación con una razón breve, citas de evidencia y los requisitos incumplidos o desconocidos.
El grado 2 significaba una coincidencia sólida: el trabajo correspondía y cada requisito explícito de la petición tenía respaldo en la publicación. El grado 1 indicaba una coincidencia parcial o información solicitada que faltaba. El grado 0 correspondía a trabajo no relacionado o a un conflicto explícito.
Una vacante remota de Python que no indica los países elegibles puede ser una coincidencia parcial para alguien que pide trabajar desde México. No debería convertirse en una coincidencia sólida porque el juez sea optimista sobre el empleador. El silencio sobre un requisito sigue siendo silencio.
Los 1,399 pares recibieron evaluaciones aceptadas. Dos peticiones encontraron errores HTTP 520 y funcionaron al reintentarlas. El ejecutor rechazó las respuestas inválidas en lugar de convertir llamadas fallidas en etiquetas negativas.
Sigo teniendo la opinión de un solo modelo sobre la relevancia. La evaluación a ciegas elimina una fuente evidente de favoritismo, pero no los errores del juez. Estas etiquetas son provisionales. El informe incluye las evaluaciones individuales y la evidencia de las publicaciones para que se puedan revisar esas decisiones.
Dos métricas, dos conclusiones distintas
La métrica de ordenamiento fue nDCG@10 sobre el conjunto evaluado. Premia los resultados útiles cerca del inicio y da más crédito a una coincidencia sólida que a una parcial. Usamos ganancias de 3 para el grado 2, 1 para el grado 1 y 0 para el grado 0, con un descuento para las posiciones inferiores. La puntuación de cada consulta se normaliza respecto al mejor orden posible dentro de su conjunto evaluado.
Cuarenta y cinco consultas tenían al menos una vacante relevante en ese conjunto. Esas consultas entraron en el promedio de ordenamiento. Las otras tres se excluyeron de nDCG, pero permanecieron en el cálculo de precisión estricta que aparece abajo.
| Método | nDCG@10 del conjunto evaluado, 45 consultas | Precision@5 de coincidencias sólidas, las 48 consultas | Mediana del tiempo de búsqueda |
|---|---|---|---|
| Jev | 0.630 | 13.3% | 235 ms |
| MiniLM | 0.487 | 13.8% | 29 ms |
| BGE | 0.380 | 12.5% | 33 ms |
| Arctic | 0.367 | 12.5% | 33 ms |
La primera columna favorece a Jev. La segunda me obliga a detenerme.
Para la precisión estricta conté solamente los resultados de grado 2 en las primeras cinco posiciones. Cuarenta y ocho búsquedas dan a cada método 240 posiciones posibles. Una posición vacía cuenta como un fallo. Los conteos de Jev y MiniLM fueron:
| Evaluación entre los primeros cinco resultados | Jev | MiniLM |
|---|---|---|
| Coincidencias sólidas | 32 | 33 |
| Coincidencias parciales | 107 | 81 |
| Coincidencias sólidas más parciales | 139 | 114 |
Son apariciones de pares de consulta y vacante, no vacantes distintas. Una publicación puede ser relevante para más de una consulta.
El mayor conteo de Jev vino de las coincidencias parciales. Produjo más resultados relacionados en total, mientras que el número de coincidencias claramente respaldadas cerca del inicio fue casi idéntico. Una diferencia de una coincidencia sólida tampoco demuestra que MiniLM sea mejor. Sí me impide afirmar que Jev encontró más vacantes que cumplieran todos los requisitos.
La diferencia de ordenamiento con datos reales es descriptiva. No he establecido significancia estadística ni comprobado su estabilidad con un segundo juez independiente.
Una consulta deja ver el intercambio
La petición fue: "Quiero entrevistar a usuarios y diseñar y probar experiencias de producto y prototipos."
Los primeros diez resultados de Jev contenían diez coincidencias parciales, ninguna sólida y ninguna irrelevante. MiniLM devolvió una sólida, tres parciales y seis irrelevantes.
Si estoy explorando oportunidades cercanas, podría preferir la lista de Jev. Si estoy comprobando si el sistema encontró una vacante que respalda claramente todo lo que pedí, MiniLM encontró una y Jev no.
Son objetivos de producto distintos. Agruparlos bajo la palabra "exactitud" oculta una decisión que me corresponde como constructor de la aplicación. Para requisitos estrictos, reportaría por separado la precisión de coincidencias sólidas y mostraría qué condiciones siguen siendo desconocidas.
La prueba sintética era más fácil de impresionar
Antes de la evaluación con datos reales ejecuté una prueba controlada con 72 vacantes ficticias y 48 consultas. Los hechos eran explícitos y las coincidencias esperadas se derivaban de esos hechos, no de un LLM como juez. Dieciséis consultas se usaron para desarrollo y 32 quedaron reservadas, con temas laborales distintos entre ambos grupos.
El sistema desplegado con Jev obtuvo 1.000 en nDCG@10 sobre las consultas reservadas. BGE obtuvo 0.986. El intervalo de bootstrap pareado para esa diferencia incluía cero.
Fue una comprobación útil de que el sistema podía resolver los casos construidos. Los resultados reales fueron mucho menos ordenados. BGE, que estaba cerca de Jev en el ordenamiento sintético, quedó detrás de MiniLM con las publicaciones reales.
Las descripciones breves y explícitas facilitaron el etiquetado de la prueba controlada. Las publicaciones reales tienen datos ausentes, requisitos vagos y trabajos que no encajan en una categoría limpia. Quiero ambas pruebas y quiero mantener separadas sus conclusiones.
Cuánto costó la evaluación
El juez consumió 2,634,345 tokens de entrada y 187,458 tokens de salida. El total de salida ya incluye 15,268 tokens de razonamiento.
Coloqué límites explícitos de caché después de la rúbrica compartida y de la descripción de la vacante. La petición de búsqueda, que cambiaba, venía después. Las peticiones correspondientes a una misma publicación se ejecutaron secuencialmente para que las evaluaciones posteriores pudieran reutilizar su prefijo; distintas publicaciones se procesaron en paralelo.
La API reportó 2,485,742 tokens de entrada en caché, el 94.4% de la entrada. Con las tarifas estándar publicadas de GPT-6.1 Sol, el uso registrado costó aproximadamente $2.48. Los mismos conteos sin caché costarían unos $7.14. La estimación incluye cargos de escritura en caché y excluye cualquier uso no reportado de las dos peticiones fallidas. No es una factura.
Ese es el costo de evaluar. No incluye alojamiento, embeddings de documentos ni las llamadas previas de búsqueda a Jev. En la ejecución con datos reales, la mediana de latencia de MiniLM fue de unos 29 ms frente a 235 ms de Jev. Un modelo local con un índice ya construido tiene una ventaja considerable. Que la mejora de Jev justifique esa latencia depende de qué tipos de coincidencia valore la aplicación.
Qué construiría después
Para esta implementación de búsqueda de empleo mantendría MiniLM como una referencia seria. Jev tiene evidencia a su favor en relevancia graduada, y quiero probar una configuración de recuperación seguida de Jev sobre vacantes reales con la misma cobertura de candidatos y texto. No eliminaría la opción más barata a partir de estos resultados.
El experimento también me deja interesado en otro uso de Jev: elegir la siguiente acción en una situación que cambia. Escribí un concepto llamado ReplayOps, un simulador pequeño de respuesta a incidentes. Llega una alerta, el modelo elige una acción acotada, el simulador cambia de estado y la siguiente decisión debe considerar lo ocurrido.
El mismo mensaje de "los errores aumentaron después del despliegue" podría justificar una reversión cuando es reversible, o una investigación cuando la versión actual incluyó un cambio incompatible de esquema. Un ciclo de reinicios debería acumular un costo visible. Un modelo con incertidumbre debería poder pedir evidencia o escalar el caso.
Ese concepto todavía no tiene resultados de modelos. Necesitaría una referencia competente basada en reglas y un LLM convencional, con el éxito medido por los resultados del simulador. Si Jev puede resolver más incidentes no vistos con una tasa de error aceptable y menor latencia o costo, eso sería evidencia de un papel útil en un ciclo de decisiones.
Por ahora, el resultado medido es más limitado: Jev mejoró la relevancia general de este sistema de búsqueda de empleo. MiniLM encontró casi la misma cantidad de coincidencias sólidas entre los primeros cinco resultados y las devolvió mucho más rápido. Mantendré esa distinción en la siguiente evaluación.
Evidencia y límites
El informe completo contiene conteos por consulta, resúmenes del ordenamiento frente a las etiquetas y enlaces a cada evaluación. La contabilidad de tokens registra lecturas y escrituras de caché y los supuestos de precios.
Las 48 intenciones se definieron de antemano para la prueba; no se tomaron de tráfico real de usuarios. Las mismas intenciones se usaron en las pruebas controlada y real. Las etiquetas del conjunto evaluado no permiten establecer exhaustividad sobre todo el corpus ni demostrar que no había vacantes relevantes fuera del conjunto. Un juez y un corpus pequeño no bastan para declarar un ganador universal.
Conservé las capturas de resultados de búsqueda, las evaluaciones estructuradas, los registros de intentos, el código de evaluación y las conclusiones en un archivo verificado mediante sumas de comprobación. No se capturaron las respuestas HTTP originales completas. Los cuerpos de petición reconstruidos están identificados como reconstrucciones. Esa es la evidencia disponible de esta ejecución.